ITSM-система — единственная, где тикет превращается в изменение продакшена по кнопке: инцидент → диагностика → change request → деплой фикса. Агент, поселенный в этот контур, стоит ближе к рубильнику, чем агент в CRM или почте. Неудивительно, что вендоры 2026 года пошли именно сюда: в мае ServiceNow открыл всю систему действий любому AI-агенту через Action Fabric и MCP-сервер, а Atlassian вывел agents in Jira в открытую бету — с назначением работ, @mention и встройкой в workflow. Вопрос для внедряющей стороны прежний: где граница между «помогает с тикетами» и «меняет инфраструктуру без спроса».
Почему ITSM — особая система
Три свойства выделяют ITSM среди корпоративных систем для агентов. Во-первых, легитимное изменение прода: в отличие от CRM, где движение воронки — бизнес-операция, здесь изменение инфраструктуры — штатная работа, и отличить санкционированное изменение от самодеятельности агента можно только по следу согласований. Во-вторых, привилегированные данные: тикеты содержат пароли в открытом виде («мой пароль не работает, вот он»), доступы, сетевые схемы, персональные данные сотрудников. В-третьих, скорость эскалации: misclassified P4, который агент «починил» рестартом сервиса, — это уже воздействие на прод, хотя начиналось как чтение.
Ландшафт 2026: действия как управляемый ресурс
Два анонса задают рамку года. ServiceNow Action Fabric открывает «систему действий» внешним агентам — Claude в терминале, Copilot в Teams, самописным — через MCP-сервер с AICT governance, metering, managed OAuth, enterprise audit trails, session management и role-based пакетами инструментов. Важно: вендор продаёт не доступ к данным, а governed execution — связку ситуационной осведомлённости (Knowledge Graph, Context Engine) с управляемым исполнением (workflows, playbooks, business rules). Каждое действие агента через платформу порождает операционные данные обратно в process mining, CMDB и аналитику.
Atlassian идёт со стороны трекера: agents in Jira работают внутри существующих структур — permissions, project configurations, workflows, audit trails наследуются, апдейты агента пишутся в историю work item рядом с человеческими. Доступно назначение работ агентам, @mention для итераций, встройка в переходы статусов. Администратор централизованно решает, какие агенты кому доступны и что такое «done».
Оба подхода сходятся в одном: агент действует внутри governance платформы, а не рядом с ней. Если ваш агент ходит в ITSM мимо этих механизмов — прямым админским ключом в API — вы строите теневой контур управления изменениями.
Четыре уровня доступа
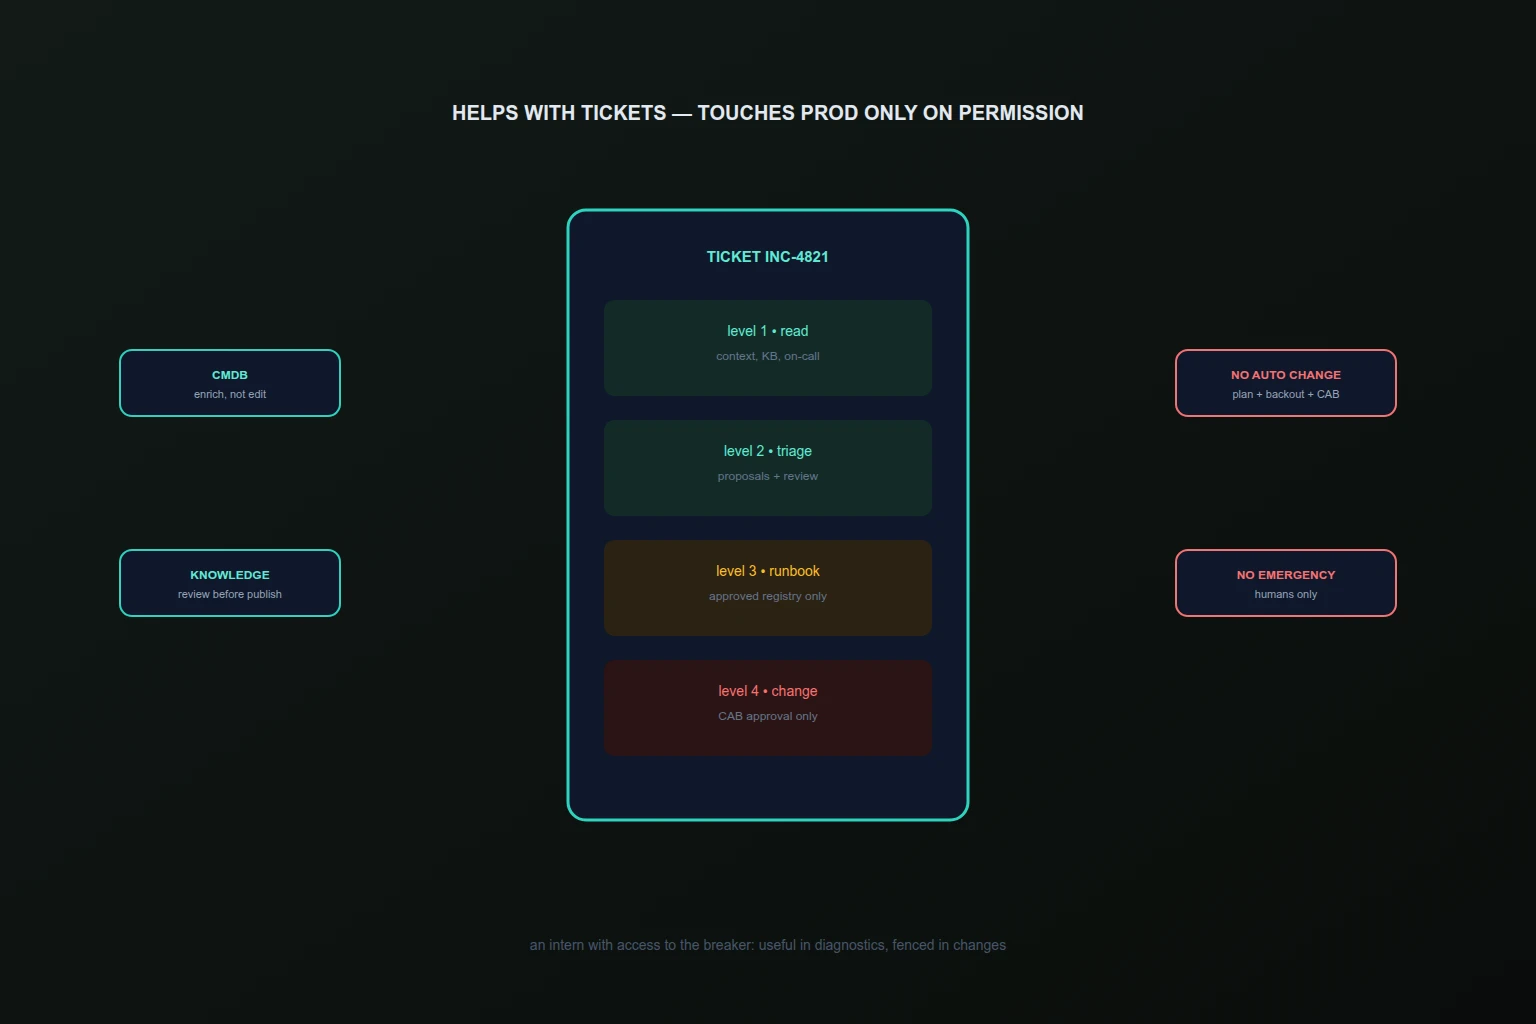
Уровень 1. Чтение и контекст. Агент видит тикеты, активы звонящего, похожие инциденты, базу знаний, дежурных. Даже здесь: scope по очередям и проектам, маскирование секретов в теле тикетов (пароли в открытом виде — норма, а не исключение), запрет массового экспорта базы знаний наружу.
Уровень 2. Классификация и триаж. Категория, подкатегория, CI, связка с major incident и problem, черновик плана решения в work notes. Всё — предложениями с human review: misclassified инцидент стоит дороже непоклассифицированного, потому что едет не туда автоматически.
Уровень 3. Действия по runbook. Сброс пароля, provisioning, типовые remediation из плейбука — детерминированные шаги с известным blast radius. Требования: runbook версионирован и утверждён, агент не импровизирует поверх него, каждое действие — в журнале тикета, лимиты на частоту и охват.
Уровень 4. Изменения. Отдельная категория — см. ниже. Коротко: никогда автономно.
Показателен дефолт ServiceNow: сторонний доступ к агенту — off, доступ AI-специалистов — off, долгоживущая память — off. Безопасные дефолты — это дизайн-решение вендора; повторите его у себя для каждого уровня.
Change management как особая категория
Change request — место, где агент обязан быть самым слабым звеном цепи, а не самым сильным. Модель: агент готовит план (implementation, test, backout), анализирует риск и влияние, предлагает обоснование — а утверждает CAB или уполномоченный approver по матрице рисков. Агент также готовит post-incident review после major-инцидентов и уведомляет исполнителя — но ревью подписывает человек. Три правила: нет автономных изменений независимо от «низкого риска» (риск оценивает процесс, а не агент); backout-план обязателен до исполнения, а не после отказа; emergency-изменения агентом не проводятся в принципе — только человеком с последующим разбором.
База знаний и CMDB
Два связных ресурса требуют отдельных политик. База знаний: агент читает для диагностики, но публикация и правка статей — через ревью экспертов; иначе галлюцинация агента оседает в корпоративной базе как «официальная» статья и отравляет будущие диагностики — тот же механизм memory poisoning, только с печатью. CMDB: агент обогащает связями из инцидентов (какие CI затронуты), но не правит инвентарь напрямую — расхождение CMDB с реальностью ломает change-оценку для всех. В обе стороны — re-certification: кто отвечает за свежесть того, что агент написал.
Дежурства и эскалации
Агент не дежурит — он маршрутизирует. Who-is-on-call, ростеры, правила эскалации — чтение для агента, изменение — для людей. Автономные уведомления (SMS через Twilio и аналоги) — отдельное разрешение с allowlist получателей и rate limit: спам-рассылка «агент всех оповестил» в 4 утра — тоже инцидент. Правило эскалации для самого агента: непонятный инцидент — человеку, а не «попробую ещё три инструмента».
Журнал по тикету
Аудит ITSM-действий читается по тикету: что агент прочитал, предложил, выполнил; чей approval и с каким контекстом; что изменилось в проде с планом и backout-статусом. Approved-апдейты — в истории work item рядом с человеческими, как в модели Jira: единая лента ответственности вместо двух параллельных реальностей. Для SOC — та же трасса плюс связка «поручение → вызовы → изменения» и алерты на аномалии (агент ночью правит CMDB — событие, а не фон).
Чеклист подключения
- Уровни 1–3 разведены скоупами; уровень 4 (изменения) — только через CAB/approval, без исключений.
- Дефолты безопасные: сторонний доступ, специалисты, долгоживущая память — off до решения.
- Секреты в тикетах маскируются до модели; массовый экспорт запрещён технически.
- Классификация — предложениями с ревью; runbook — версионированы, импровизация запрещена.
- База знаний и CMDB: агент предлагает, эксперты утверждают; ресертификация назначена.
- Уведомления — allowlist получателей и rate limit; дежурства меняет только человек.
- Журнал по тикету: чтение, предложения, действия, approval, изменения в проде.
- Emergency-изменения — только люди; post-incident review подписывает человек.
Где Codenik
Codenik отдаёт ITSM агенту инструментами со скоупами по уровням: чтение очередей широко, классификация — с обязательным ревью-шагом, runbook-действия — только из утверждённого реестра, изменения — через approval с планом и backout в пакете. Секреты из тикетов режутся до модели, массовый экспорт отсутствует как инструмент, каждое действие пишется в журнал тикета с трассой поручения. Вендорские governance-механизмы (Action Fabric, Jira permissions) при этом не дублируются, а дополняются единым контуром поверх всех систем сразу — один approval, один журнал, один отзыв.
Короткий вывод
Агент в ITSM — это стажёр с доступом к рубильнику: полезен в диагностике и рутине, опасен в изменениях. Давайте чтение широко, классификацию — с ревью, runbook — из реестра, а изменения — только через CAB с планом и backout. Тогда тикеты будут закрываться быстрее, а прод — меняться только тогда, когда это решили люди.