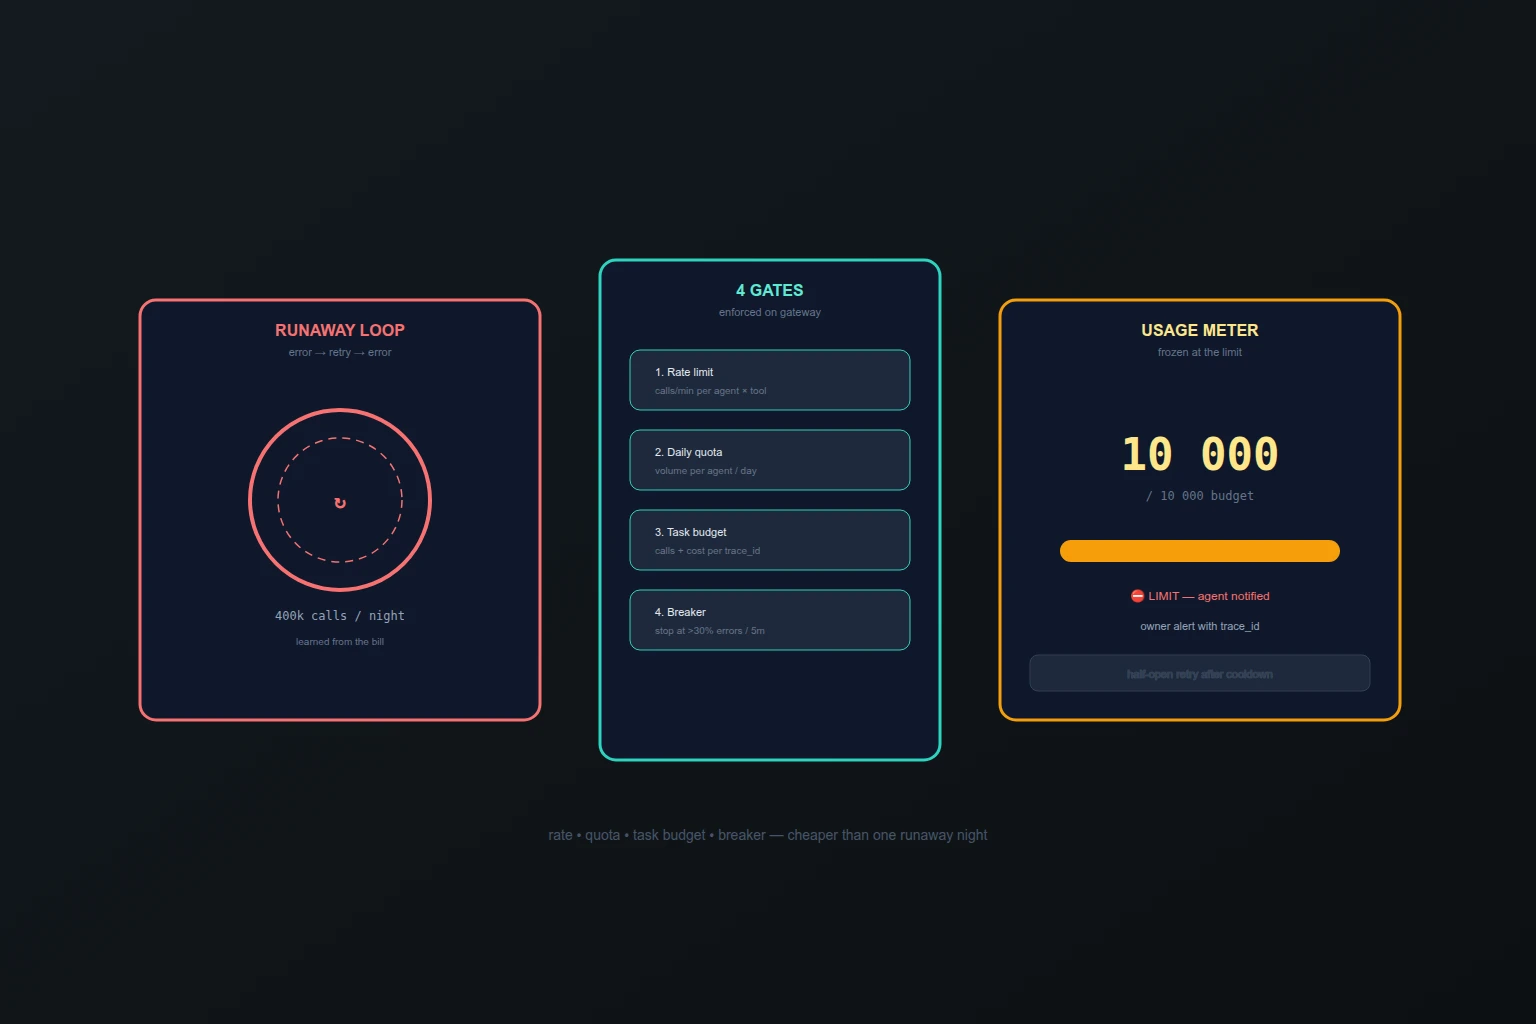
Классический инцидент: агент не получил ожидаемый ответ, ушёл в retry, к утру — сотни тысяч вызовов в платный API и счёт, который заметила бухгалтерия. Промпт «не делай лишних вызовов» такие циклы не останавливает: модель не считает итерации. Останавливают их лимиты, применённые не в голове агента, а на границе — там, где вызовы можно посчитать и отрезать.
Чем runaway-агент отличается от обычного перерасхода
Обычный перерасход — линейный: много задач, много вызовов. Runaway — экспоненциальный: один агент в петле ошибка → retry → ошибка, каждый виток дёргает инструменты, каждый инструмент стоит денег или грузит прод. Триггеры типичные: листинг без пагинации («прочитай все тикеты»), поиск без стоп-условия, инструмент, всегда возвращающий ошибку, которую агент «чинит» повторением. Узнают о таком из счёта или падения API — значит, лимитов не было.
4 уровня лимитов
- Rate limit — вызовов в минуту на связку
агент × инструмент. Режет петли мгновенно: легитимный сценарий редко требует больше десятков вызовов в минуту от одного агента. В гайдах по защите MCP-серверов per-agent лимиты стоят в базовом чек-листе прода. - Дневная квота — суммарных вызовов на агента в сутки. Ловит медленные утечки: агент не в петле, но каждый день тянет лишнее.
- Бюджет на задачу — лимит вызовов и стоимости на один
trace_id/workflow_id. Самая точная граница: задача «обнови 5 тикетов» не может стоить 10 000 вызовов. - Circuit breaker — автоостановка при доле ошибок выше порога (например, >30% за 5 минут): агент «ломает» инструмент — вызовы блокируются, владельцу уходит алерт.
Уровни дополняют друг друга: rate режет скорость, квота — объём, бюджет — смысл, breaker — бессмысленность.
Где применять: шлюз, а не промпт
Лимиты в системном промпте — пожелание. Лимиты на шлюзе — enforcement: каждый tools/call проходит счётчик до исполнения, превышение возвращает ошибку, которую агент видит и обязан обработать. Там же короткоживущие токены и deny-by-default — тот же слой, та же точка контроля. Агентский фреймворк при этом менять не нужно.
Легитимные пики vs аномалия
Грубые лимиты душат нормальную работу: миграционный агент легитимно делает тысячи read-вызовов. Поэтому:
- read и write — разные лимиты (read щедрее на порядок);
- разовые задачи получают повышенный бюджет через approve владельца, а не навсегда;
- baseline считается по истории агента: алерт при отклонении ×5 от его же нормы, а не от глобального порога;
- пакетные операции идут через один bulk-инструмент, а не тысячу одиночных вызовов.
Лимит должен резать аномалию, а не продуктивность.
Алерты и circuit breaker
Каждый сработавший лимит — событие в журнал: agent_id × tool × limit_type × usage × threshold. Владелец получает алерт с контекстом задачи, а не «превышен лимит N». Breaker переводится в half-open автоматически через cooldown: один пробный вызов, успех — открываем, снова ошибки — держим закрытым и эскалируем человеку.
Где Codenik
Codenik применяет все четыре уровня на каждый tools/call: per-agent rate, дневные квоты, бюджет на задачу и breaker по доле ошибок. Превышение — структурированная ошибка агенту и алерт владельцу с trace_id. Лимиты версионируются вместе с политиками: видно, кто и когда ослабил квоту миграционному агенту.
Короткий вывод
Агент без лимитов — это while(true) с доступом к вашей кредитке. Rate, квота, бюджет на задачу и breaker на шлюзе стоят дешевле одного ночного runaway — поставьте их до первого счёта, а не после.