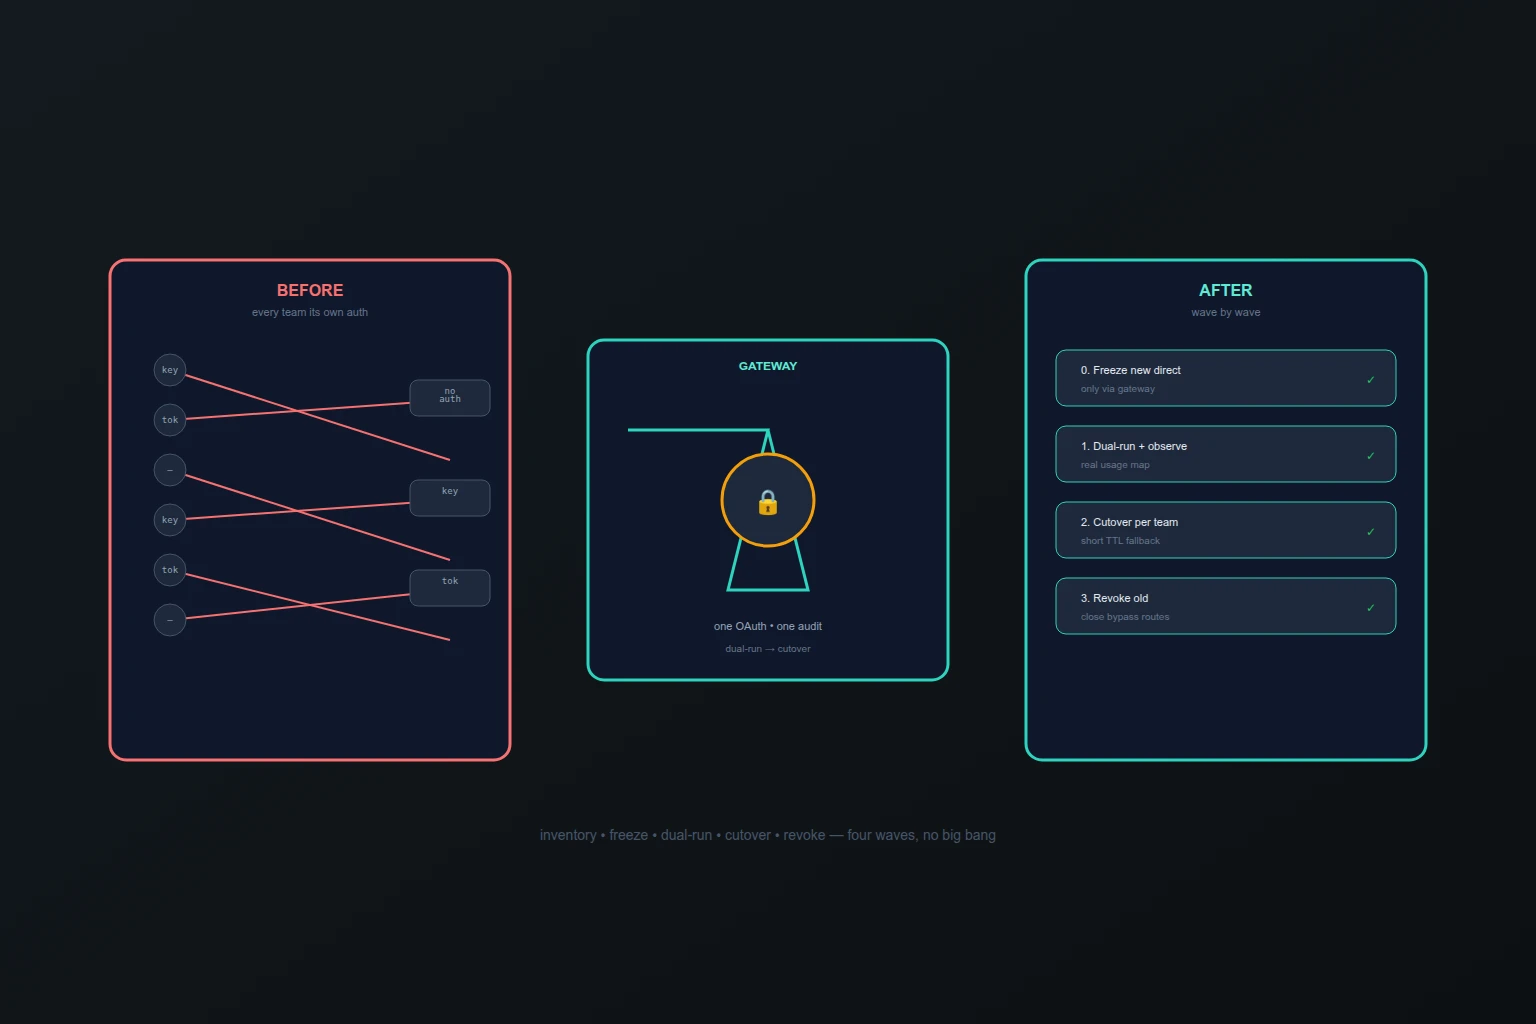
Типовая картина через год после знакомства компании с MCP: десятки внутренне написанных серверов, у каждого своя авторизация — где-то API-ключи, где-то общий токен в .env, где-то ничего. Свежая исследовательская работа по production-внедрению так и описывает кризис: скорость породила фрагментированный ландшафт без единого способа понять, кто кого вызывал, и отозвать доступ уволившегося сотрудника сразу везде. Лечится это шлюзом, но «просто поставить шлюз» ломает работу команд. Нужна миграция волнами.
Диагноз: фрагментированная авторизация
Прежде чем двигать, зафиксируйте что есть: список серверов, транспорт (stdio/HTTP), метод авторизации каждого, владельцы, какие агенты и команды зависят. Отдельно пометьте серверы без авторизации и с shared-токенами — это первая очередь. Инвентарь — тот же реестр, который потом станет конфигурацией шлюза, поэтому делайте его в машиночитаемом виде сразу.
Волна 0: заморозка нового
Правило с первого дня: новые серверы и интеграции — только через шлюз. Иначе очередь будет расти быстрее миграции. Параллельно договоритесь о целевом состоянии: вся сетевая авторизация — OAuth с короткоживущими токенами, секреты — в брокере, каждый вызов — в журнале. Практика вендоров подтверждает подход: при переключении с токенного доступа на централизованный старый токен отзывается — две системы не живут параллельно вечно.
Волна 1: шлюз рядом, dual-run
Шлюз встаёт перед существующими серверами как прокси, ничего не ломая: трафик идёт и напрямую, и через шлюз. На этом этапе шлюз работает в режиме observe — пишет журнал, считает использование scope, показывает, какие токены реально ходят. Через пару недель у вас фактическая карта вместо догадок: кто, куда, как часто. Неиспользуемые серверы и мёртвые токены отзываются уже сейчас, до cutover.
Волна 2: cutover по командам
Перевод — по одной команде за раз, начиная с самой договороспособной:
- команде выдают доступ через шлюз с теми же scope, что были;
- прямые токены команды переводят на короткий TTL как страховку отката;
- сверяют журнал «было/стало» по объёму и ошибкам;
- при расхождении — откат TTL, разбор, повтор.
Критерий готовности следующей команды — предыдущая неделю живёт только через шлюз. Персональные токены людей при этом заменяются сервисными аккаунтами для неинтерактивных сценариев: владелец увольняется — личный токен умирает вместе с доступом, сервисный живёт под владельцем-командой.
Волна 3: отзыв старого и запрет обходов
Финал — технический, а не организационный: прямые маршруты закрываются на сети (allowlist только шлюза), старые токены отзываются, подключение новых серверов в обход шлюза блокируется ревью. Без этого шага миграция «почти завершена» навсегда: один прямой токен обнуляет весь аудит. Контрольная проверка — сканирование конфигов агентов на прямые URL и секреты.
Где Codenik
Codenik встаёт целевым шлюзом: проксирует существующие серверы без их переписывания, даёт единую OAuth-авторизацию, брокер секретов и журнал с первого дня dual-run. Cutover — переключением маршрутов и TTL, отзыв — одной операцией. То, что команды видят как «тот же сервер, но со входом по SSO», для безопасности — конец фрагментации.
Короткий вывод
Миграция на шлюз — это инвентарь, заморозка нового, dual-run с наблюдением, cutover по командам и закрытие обходов. Четыре волны вместо большого взрыва — и через квартал у каждого вызова есть владелец, scope и запись в журнале.