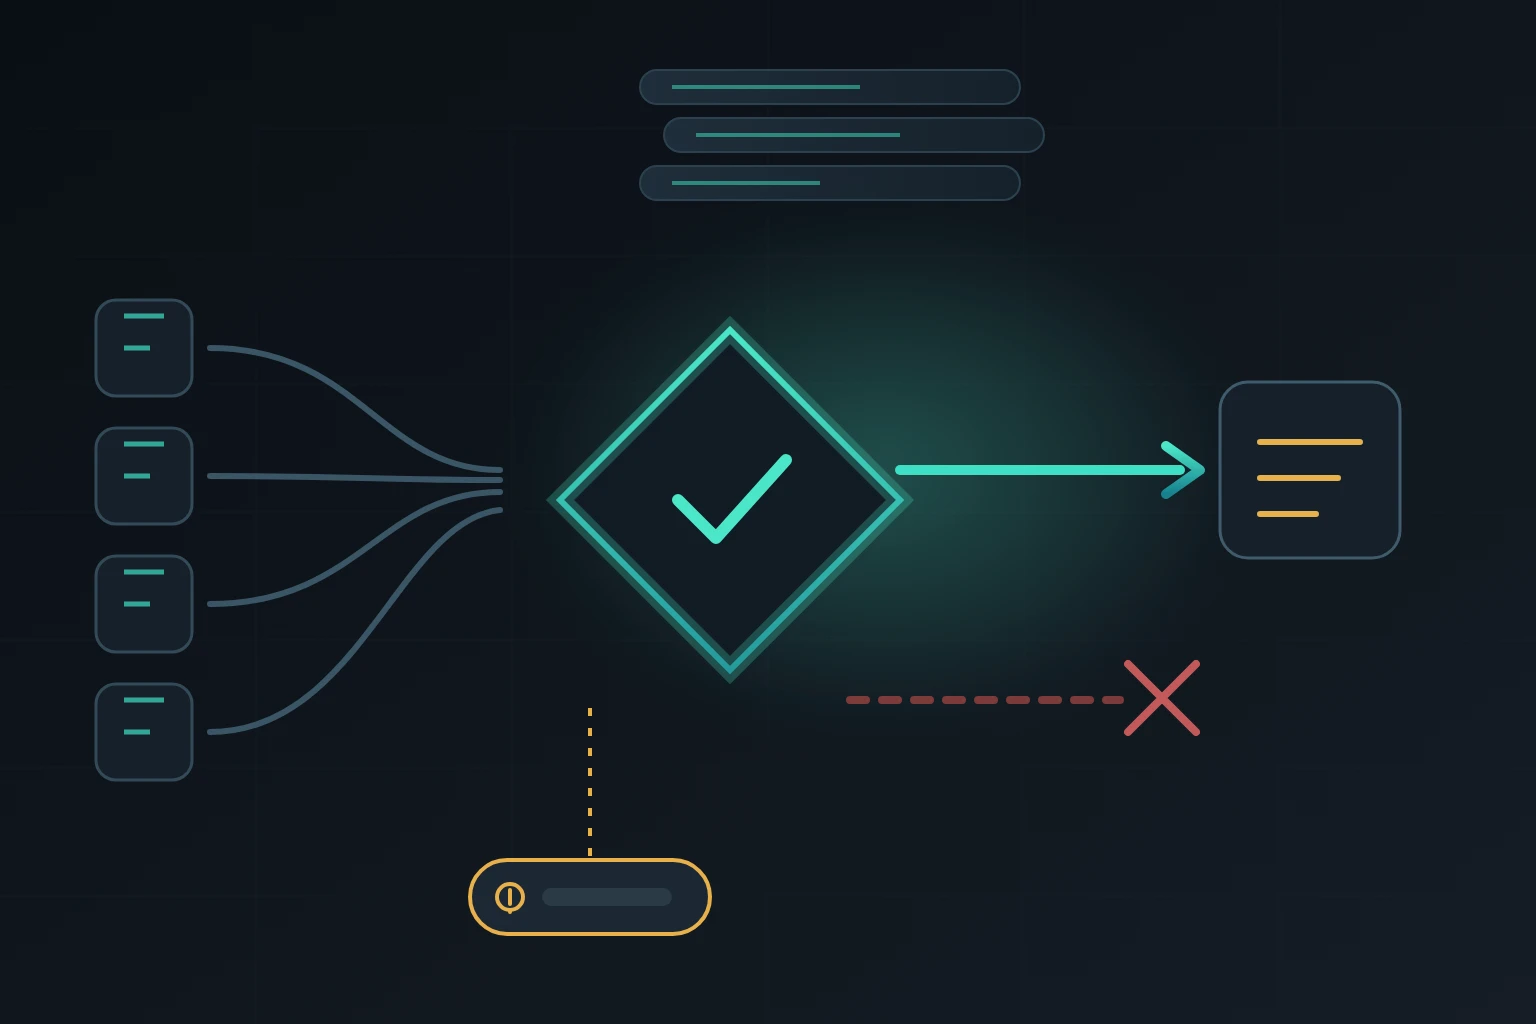
«Удалять данные можно только с подтверждением», «в прод не ходим без тикета», «секреты не трогаем» — такие правила живут в системном промпте агента и в голове тимлида. Проблема в том, что промпт не является границей безопасности. Это текст, который модель может проигнорировать, переписать в ответ на инъекцию или просто понять иначе, чем подразумевал автор.
Граница появляется там, где решение принимает не модель, а отдельный компонент по формальным правилам. В мире инфраструктуры это давно называется policy-as-code: правила лежат в репозитории, проходят ревью и тесты, версионируются и применяются одинаково к любому запросу. Для агентов та же схема работает — с одной важной поправкой: правила надо ставить не вокруг человека, а вокруг каждого вызова инструмента.
Ниже — как выглядит архитектура с точкой принятия решения, что именно проверять, чем отличаются OPA и Cedar, как не превратить политику в новую форму «надеемся, что сработает» и в каком порядке это внедрять, чтобы не остановить работу команд.
Главное за минуту
- PEP и PDP. Точка исполнения (PEP) стоит перед инструментом, точка решения (PDP) отвечает «можно или нет». Модель не участвует в решении.
- Факты нормализует хост, а не агент. Идентичность, тенант, класс риска и канонические аргументы берутся из контролируемых источников.
- Deny by default. Разрешение — только явный
permit. Ошибка, таймаут, кривой ответ движка — это тоже отказ. - Политика сужает права, но не заменяет инварианты. Изоляция тенантов, аудитория токена и срок жизни гранта остаются жёсткими проверками в коде.
- OPA и Cedar решают одну задачу по-разному. Rego гибче и лучше ложится на гетерогенные данные, Cedar строже и проверяем формально.
- Политику надо тестировать как код, включая мутационные тесты: уберите одно условие — тест должен покраснеть.
Почему промпт не является политикой
Промпт-инструкция и политика доступа выглядят похоже, но у них разные свойства.
| Свойство | Промпт | Политика |
|---|---|---|
| Исполнение | вероятностное | детерминированное |
| Проверка | «на глаз» в диалоге | unit-тесты и CI |
| Изменение | правка текста | ревью, версия, раскатка |
| Отказ | модель может «передумать» | явный deny |
| Аудит | нет трассировки решения | есть запись с причиной |
Промпт хорош для того, чтобы агент вёл себя осмысленно: выбирал инструменты, задавал уточняющие вопросы, не выдумывал факты. Но он не даёт гарантий. Если доступ к delete_repo определяется фразой в инструкции, то инъекция в описании инструмента, в тикете или в тексте документа может эту фразу перевесить.
Политика работает иначе: она не уговаривает модель, а отвечает на конкретный вопрос о конкретном запросе. Модель может сколько угодно «решить» удалить репозиторий — вызов не пройдёт, если политика не разрешает.
Три компонента и одна граница
Рабочая схема состоит из трёх частей.
Агент формирует намерение: имя инструмента и аргументы. Больше ничего он не контролирует.
Нормализатор превращает намерение в проверяемый запрос. Он живёт на стороне хоста и берёт факты из доверенных источников: идентичность и тенант — из проверенной аутентификации, класс операции и уровень риска — из каталога инструментов, ресурсы — из канонизированных путей, согласия — из хранилища подтверждений. Всё, что агент «утверждает» о себе сам, отбрасывается.
PDP оценивает нормализованный запрос по политике и возвращает решение: permit, deny или «нужно подтверждение». PEP исполняет только явный permit.
Ключевое свойство — граница после нормализатора. Всё, что пришло от модели, не пересекает её напрямую. Модель не может понизить класс риска своего действия, подставить другой тенант или выдать строку, похожую на путь, за право доступа.
Типичная ошибка — поставить PDP перед агентом, а не перед инструментом. Тогда проверяется намерение («агент хочет поработать с репозиториями»), а не действие («удалить ветку main в репозитории X»). Проверять нужно второй вариант.
Нормализация: что именно проверять
Хороший запрос на решение выглядит как структура с фиксированной схемой, а не как свободный JSON от агента.
{
  "principal": { "type": "agent", "id": "agent:sales-assistant", "on_behalf_of": "user:anna" },
  "tenant": "org_42",
  "action": "tool:submit_payment",
  "resource": { "kind": "payment", "id": "pay_4581", "amount": 1240000, "currency": "RUB" },
  "context": {
    "grant_id": "gr_9f2",
    "grant_expires_at": "2026-10-24T12:15:00Z",
    "risk": "financial",
    "approval": { "id": "APR-2026-000184", "args_hash": "sha256:8f3c" },
    "request_id": "req_01J9"
  }
}
Что здесь важно:
on_behalf_of— отдельное поле. Агент действует от имени человека, и это должно быть видно в решении, а не выводиться из текста.amountиcurrency— числа и коды, а не строки из аргументов. Нормализатор парсит и валидирует; «1 240 000», «1240000.00» и «1240000» должны привестись к одному виду, иначе лимит обходится сменой формата.args_hashпривязывает подтверждение к тем аргументам, которые человек видел.riskберётся из каталога инструментов, а не из аннотаций, которые прислал сервер. Аннотации вродеreadOnlyHint— подсказка для клиента, а не основание для доверия.tenant— из токена или сессии, не из тела запроса.
Если поля нет, запрос не «дополняется значением по умолчанию», а отклоняется. Политика не должна догадываться.
Deny by default и три исхода вместо двух
Главное правило: отсутствие разрешения — это отказ. Не «предупреждение в лог», не «пропустим, если админ», а deny.
У решения три исхода, а не два:
- permit — выполнить;
- deny — не выполнять;
- review — выполнить нельзя, но можно отправить на подтверждение человеку.
Третий исход нужен, потому что иначе команды начинают разрешать «на всякий случай», а потом удивляются. Классификация по риску позволяет держать чтение открытым, запись — через review, а необратимые операции — через review с дополнительными условиями.
Отдельно про ошибки. Если PDP недоступен, вернул мусор, превысил таймаут или ответ не прошёл схему — это deny. Не «fail open, чтобы не сломать работу». Именно fail-open превращает движок политик в декорацию: достаточно уронить sidecar, и агент получает полный доступ.
Компромисс для доступности — кэш решений на короткий TTL с явной инвалидацией при изменении гранта. Но кэшировать надо решения для конкретного запроса, а не «разрешение для инструмента вообще».
OPA и Rego: гибкий движок для гетерогенных правил
Open Policy Agent — выпущенный в CNCF универсальный движок политик. Политики пишутся на Rego, декларативном языке, близком к Datalog. Запрос — JSON на входе, решение — JSON на выходе; политики и данные распространяются бандлами, движок умеет горячую перезагрузку.
Для агентов OPA удобен тем, что умеет соединять данные: каталог инструментов, список тенантов, таблицу лимитов, чёрные списки. Типичный шаблон — sidecar перед шлюзом, который вызывает OPA перед выполнением инструмента.
Пример политики для вызовов инструментов:
package agent.tools

default allow := false
default review := false

# Разрешаем read-инструменты в рамках выданного гранта
allow if {
    input.action == "tool:read"
    tool := data.tools[input.tool]
    tool.enabled
    input.context.grant_id != ""
    not grant_expired
    input.tenant == data.grants[input.context.grant_id].tenant
}

# Финансовые операции требуют подтверждения по хешу аргументов
review if {
    input.context.risk == "financial"
    approval := input.context.approval
    approval.args_hash == input.context.args_hash
    approval.id in data.valid_approvals
}

# Жёсткий запрет: инструменты из списка никогда не доступны агентам
deny if {
    input.tool in data.blocked_tools
}

grant_expired if {
    time.now_ns() > time.parse_rfc3339_ns(data.grants[input.context.grant_id].expires_at)
}
Тонкость: в Rego нет встроенного «forbid важнее permit». allow и deny — обычные имена правил, и приоритет задаёт автор политики. Стандартный приём — отдельное итоговое правило, которое возвращает permit только при allow и отсутствии deny. Работает, но приоритет надо не забыть в каждом пакете; это как раз тот класс ошибок, который ловится тестами, а не глазами.
Сильные стороны OPA: один движок на разные домены (Kubernetes, Terraform, API, агенты), богатая работа с данными, зрелая экосистема. Слабости: Rego требует смены мышления, схемы нет, а ошибки в правилах всплывают на конкретном запросе.
Cedar: строгая модель и проверяемость
Cedar — язык авторизации, спроектированный вокруг четырёх сущностей: principal, action, resource, context. У него есть схема, политики валидируются до запуска, а модель решений простая и предсказуемая: по умолчанию отказ, permit разрешает, forbid перекрывает любой permit, порядок политик не важен.
// Агенту разрешено читать в своём тенанте
permit (
    principal is Agent,
    action in [Action::"tool:read", Action::"tool:list"],
    resource
) when {
    principal.tenant == resource.tenant &&
    context.grant_active == true
};

// Финансовые операции запрещены без подтверждения
forbid (
    principal,
    action == Action::"tool:submit_payment",
    resource
) unless {
    context.risk == "financial" &&
    context.approval_args_hash == context.args_hash
};

// Удаление недоступно агентам вообще
forbid (
    principal is Agent,
    action in [Action::"tool:delete", Action::"tool:drop"],
    resource
);
Что даёт такая конструкция:
- Запрет невозможно «перебить» разрешением. Это свойство движка, а не дисциплина автора.
- Схема отсекает ошибки до продакшена. Политика, обращающаяся к несуществующему атрибуту, не пройдёт валидацию.
- Можно рассуждать о наборе политик, а не только о каждом запросе по отдельности: часть инструментов позволяет доказывать свойства набора, а не проверять его примерами.
Ограничение: Cedar заточен под авторизацию, и сложные вычисления в нём писать неудобно (и не нужно). Для «соединить пять таблиц и посчитать остаток лимита» он не предназначен — такие вещи считаются до вызова политики и передаются в контексте.
Как выбрать движок
| Критерий | OPA / Rego | Cedar |
|---|---|---|
| Модель | универсальная оценка политик | авторизация |
| Схема | нет, только конвенции | встроенная |
| Приоритет запрета | задаёт автор политики | forbid всегда перекрывает |
| Соединение данных | сильная сторона | ограниченно |
| Проверка набора правил | тесты | тесты и формальный анализ |
| Экосистема | широкая, CNCF | растёт, вокруг AWS |
| Порог входа | высокий | низкий |
Практическое правило: если у вас уже есть OPA для Kubernetes и CI, ставить второй движок только ради агентов — сомнительная идея. Если вы строите авторизацию приложения с нуля и хотите предсказуемости, Cedar даёт более надёжную базу.
Запускать оба движка в одном пути запроса не стоит: двойная сложность и расхождение в диагностике. Парная оценка имеет смысл только на время миграции или теневой проверки.
Что политика решать не должна
Есть класс проверок, которые нельзя отдавать в опциональную политику, потому что это не «правила», а инварианты системы:
- токен выписан именно этому ресурсу (audience);
- грант существует, не отозван и не истёк;
- тенант запроса совпадает с тенантом ресурса;
- у агента нет права использовать пользовательское подключение как своё;
- инструмент вообще включён в каталоге.
Политика может сузить эти права, но не расширить. Если инвариант проверяется только политикой, достаточно одной ошибки в бандле, чтобы его не стало.
Ещё одна вещь, которую политика не должна делать: доверять меткам, которые предлагает агент. Если модель может написать classification: public в аргументах и политика это читает — она читает показания обвиняемого.
Версионирование контракта решения
Политика без версии контракта ломается тихо. Через полгода кто-то добавит поле в нормализованный запрос, а правило будет его игнорировать — и решение станет шире, чем задумано.
Держите вместе, в одном репозитории и одном релизе:
- схему входного запроса;
- текст политики;
- версию снапшота данных (каталог инструментов, лимиты, гранты);
- коды причин отказа.
И правило: неизвестное поле в запросе — отказ. Иначе новая возможность, добавленная в нормализатор, молча не будет учитываться политикой.
Причины отказа тоже часть контракта. deny с кодом tenant_mismatch и deny с кодом grant_expired требуют разных действий: в первом случае чинить интеграцию, во втором — перевыпустить доступ. Без кодов разбор инцидента превращается в гадание по логам.
Раскатка: теневой режим, предупреждения, блокировка
Политика, включённая сразу в блокирующем режиме, обычно ломает работу: находятся сценарии, которых никто не предусмотрел. Поэтому три фазы.
1. Тень. Политика оценивает каждый вызов, пишет решение и причину, но не влияет на исполнение. Вы собираете статистику: сколько было бы отказов, какие инструменты чаще всего попадают в review, какие причины доминируют.
2. Предупреждение. Отказы становятся видимыми: агент получает понятную ошибку, в логах — код причины, но вызов проходит. Здесь отлавливаются ложные срабатывания.
3. Блокировка. Deny реально блокирует. С этого момента изменения политики идут через ревью и канареечную раскатку на часть трафика.
Пропускать фазы нельзя: в теневом режиме видно, что политика в принципе ошибается, а в предупреждении — что она ошибается на живых людях.
Отдельно: политика должна переживать откат. Бандлы версионируются, предыдущая версия хранится, переключение — одна операция. Если после раскатки выяснилось, что правило блокирует оплату, откат должен занимать секунды, а не релиз.
Тестирование: поведение, а не форматирование
Тесты политик пишутся как тесты кода: вход, ожидаемое решение, причина. Но обычных тестов мало — они проверяют только те случаи, которые вы придумали.
Полезные наборы:
- Кросс-тенант. Агент из
org_42запрашивает ресурсorg_99. Ожидание: deny. - Отозванный грант. Грант удалён между вызовами. Ожидание: deny, даже если кэш ещё жив.
- Просроченное согласие. Человек подтвердил вчера. Ожидание: deny и новый запрос подтверждения.
- Подменённые аргументы. Хеш не совпадает. Ожидание: deny.
- Неизвестный инструмент. Запрос на инструмент, которого нет в каталоге. Ожидание: deny, а не «разрешим, раз имя похоже».
- Дефолт. Пустой запрос, отсутствующие поля. Ожидание: deny.
И мутационные тесты: уберите из политики одно обязательное условие (проверку тенанта, проверку срока) и убедитесь, что хотя бы один тест падает. Если не падает — условие не покрыто, и в продакшене его удаление никто не заметит.
Рабочий сценарий: один запрос, четыре вызова
Покажем, как это работает целиком, на задаче «подготовь и отправь счёт клиенту».
Агент получает задачу от менеджера и делает четыре вызова.
search_contracts— read. Политика: разрешено, если грант активен и тенант совпадает. Возвращаются только поля из allowlist.create_invoice_draft— write в песочницу. Политика: разрешено без подтверждения, потому что операция обратима и не покидает систему.send_invoice_email— внешняя коммуникация. Политика: review. Нормализатор собирает карточку: получатель, сумма, вложение, текст. Человек подтверждает, хеш аргументов попадает в контекст.mark_invoice_sent— изменение статуса после отправки. Политика: разрешено только при наличии подтверждения с тем жеargs_hashи при условии, что отправка действительно произошла (независимая проверка результата).
Что даёт такая схема:
- Чтение не требует человека, поэтому работа не встаёт.
- Обратимая запись не требует подтверждения, но ограничена песочницей.
- Необратимое действие уходит на подтверждение с полными параметрами.
- Финальный шаг нельзя выполнить «на всякий случай»: он привязан к подтверждённому действию.
Если агент попытается пропустить третий шаг и сразу пометить счёт отправленным, политика откажет: подтверждения с нужным хешем нет.
Производительность: где на самом деле задержка
Страх «политика замедлит агента» обычно преувеличен, но не беспочвенен. Основные источники задержки:
- Сетевой хоп до PDP. Sidecar по loopback дешевле, чем отдельный сервис по сети.
- Объём данных в политике. Правило, перебирающее большой массив, дороже, чем проверка нескольких скаляров.
- Размер контекста. Если в запрос кладут весь документ, чтобы политика «посмотрела», латентность и стоимость растут.
- Холодный старт. Первый вызов после деплоя всегда медленнее.
Практический подход: считать решение по компактному нормализованному запросу, держать данные маленькими и локальными, а тяжёлые проверки (сверка с внешней системой) делать до PDP и передавать результатом. Замеры конкретных движков публикуют сами вендоры, и сравнивать их между собой напрямую нельзя: разные сценарии, разная доля сериализации, разное железо. Свои цифры надо мерить на своём профиле вызовов.
Аудит решений
Каждое решение — событие, и оно должно быть воспроизводимым. Минимальный набор:
{
  "request_id": "req_01J9",
  "principal": "agent:sales-assistant",
  "on_behalf_of": "user:anna",
  "tenant": "org_42",
  "action": "tool:send_invoice_email",
  "resource_id": "inv_7781",
  "args_hash": "sha256:1b7e",
  "decision": "review",
  "reason": "external_communication",
  "policy": "finance/invoices@v22",
  "data_snapshot": "catalog@2026-10-24T09:00Z",
  "approval_id": null
}
Что это даёт при разборе: видно, какая версия политики и какой снапшот данных действовали в момент вызова. Без этого через месяц невозможно ответить на вопрос «почему это было разрешено».
Чего не должно быть в записи: полных аргументов с персональными данными, содержимого документов, секретов. Хеш аргументов плюс идентификатор ресурса обычно достаточны, а сами данные при необходимости достаются из системы-источника по идентификатору.
Чеклист внедрения
- Решение принимается перед каждым вызовом инструмента, а не перед агентом.
- Факты нормализуются на хосте: идентичность, тенант, класс риска, канонические аргументы.
- Неизвестные поля в запросе — отказ.
- Отказ по умолчанию, включая ошибки и таймауты PDP.
- Три исхода: permit, deny, review — с кодами причин.
- Инварианты (audience, срок гранта, тенант) живут в коде, а не в опциональной политике.
- Политика, схема запроса и снапшот данных версионируются вместе.
- Есть теневой режим и режим предупреждений до блокировки.
- Есть мутационные тесты, а не только примеры «разрешено/запрещено».
- Решения пишутся в аудит с версией политики и причиной.
FAQ
Можно ли обойтись аннотациями инструментов вместо политики? Нет. readOnlyHint и destructiveHint — подсказки, которые присылает сам сервер. Они полезны для UI клиента, но не являются основанием для решения: аннотации могут быть неверными или изменёнными.
Политика заменяет RBAC? Она его дополняет. Роли отвечают на вопрос «какие классы действий доступны субъекту», политика — «разрешено ли это конкретное действие в этом контексте». Часто RBAC-факты просто становятся частью контекста.
Что делать, если политика запрещает легитимный сценарий? Это не повод добавлять исключение по имени пользователя. Правильнее либо расширить нормализатор (дать политике нужный факт), либо ввести явный класс операций с отдельным правилом и подтверждением.
Нужна ли политика для read-only агента? Да, но проще: ограничение по тенанту, по полям и по объёму выборки. Основная опасность чтения — не изменение данных, а утечка.
Как часто пересобирать данные для политики? Снапшот фиксируется на момент решения и указывается в аудите. Если данные меняются часто (лимиты, гранты), проверка срока и отзыва должна идти в рантайме, а не только по снапшоту.
Где Codenik
Codenik ставит точку решения туда, где её видно: перед вызовом MCP-инструмента. Шлюз знает, кто инициировал вызов, от имени кого он идёт, какой инструмент и с какими аргументами запрошен, — и применяет политику до выполнения. Секреты подставляются на стороне шлюза, поэтому решение не зависит от того, что агент знает о системе, в которую идёт запрос.
Отдельно решается то, что обычно остаётся «на совести промпта»: подтверждения для необратимых операций, лимиты по тенанту и роли, запись решения с версией политики в аудит. Агент при этом остаётся агентом — он планирует и вызывает инструменты, но не решает, что ему можно.
Источники
- Open Policy Agent: документация по Rego, бандлам и интеграционному паттерну sidecar.
- Cedar: язык политик, схема, семантика forbid-overrides и средства анализа набора политик.
- OWASP, Agentic Top 10 и MCP Security Cheat Sheet: excessive agency, least privilege, подтверждения.
- NSA, «Model Context Protocol (MCP): Security Design Considerations»: отсутствие встроенной модели прав в MCP-реализациях.
- Практические разборы архитектуры PDP/PEP для агентов: нормализация фактов, deny-by-default, версионирование контракта решения.
- Model Context Protocol, ревизия 2026-07-28: аннотации инструментов как подсказки, а не механизм принуждения.