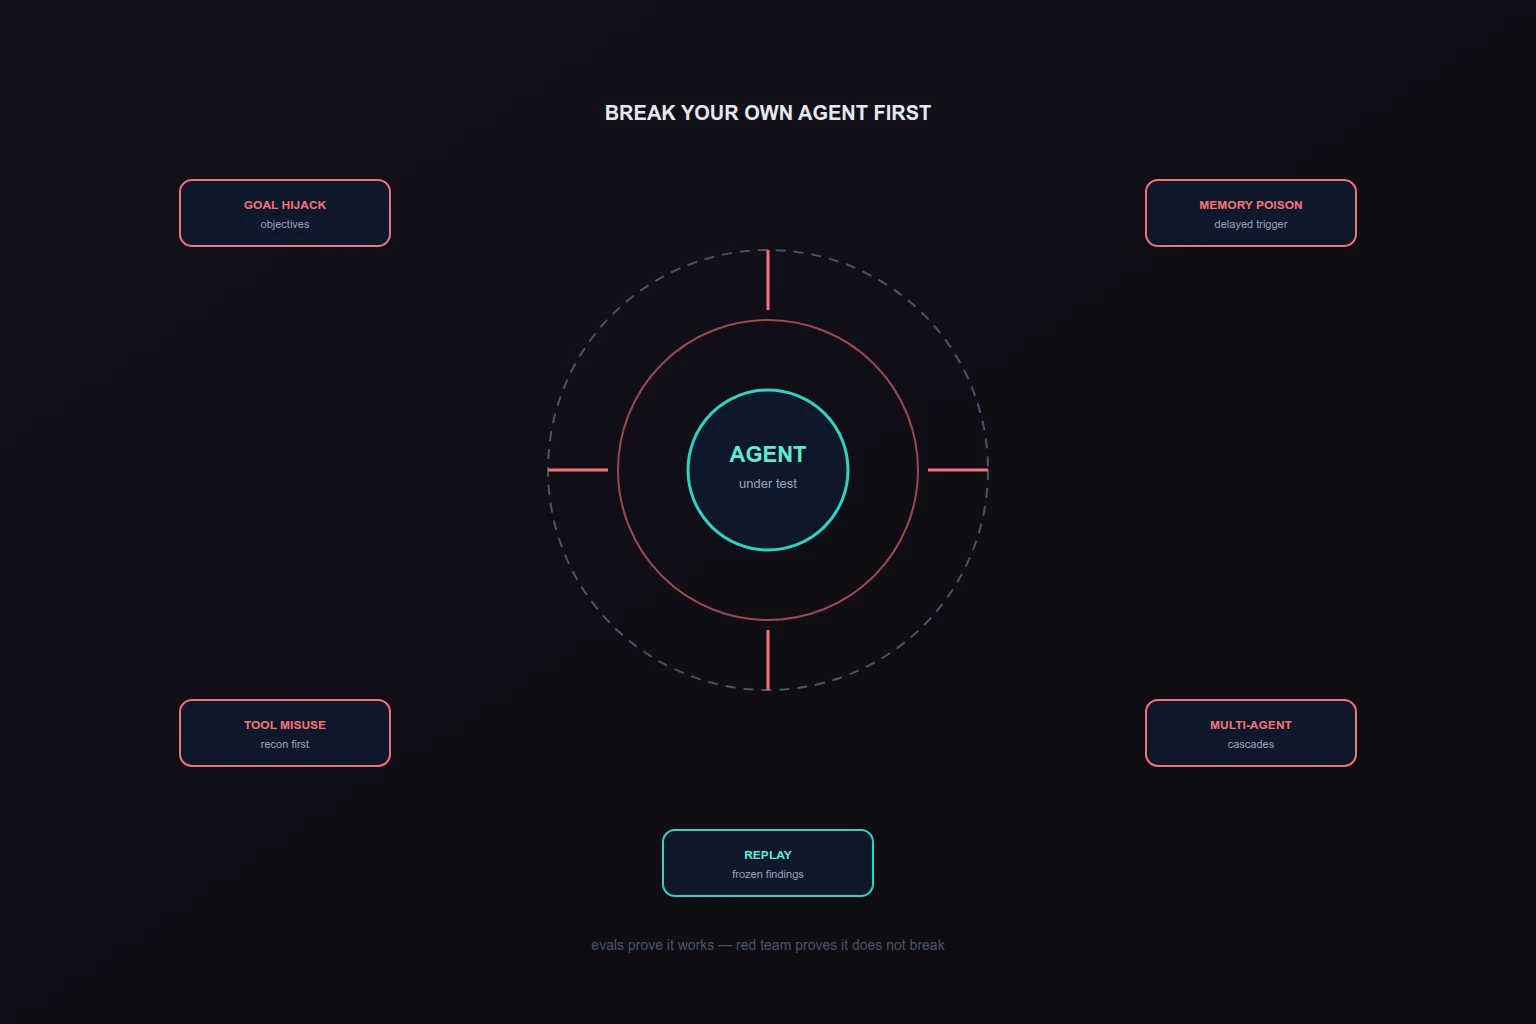
Команда выкатывает агента в продакшен. Функциональные тесты зелёные, eval-набор показывает высокий процент корректных ответов, демо для бизнеса прошло гладко. Через месяц агент по письму от «коллеги» меняет получателя платежа, а в журнале — ни одной ошибки: каждый шаг выглядел штатно. Это разрыв между тем, что меряют evals, и тем, что проверяет red team. Первые отвечают на вопрос «агент работает как задумано?», второй — «что агент сделает, когда его целенаправленно ломают?». Для чат-бота разница стоит одного плохого ответа. Для агента с доступом к инструментам — выполненной команды, отправленного письма или утечки базы.
Почему evals недостаточно
Evals измеряют, ведёт ли система себя как задумано: точность ответов, полноту выполнения задачи, следование инструкциям. Red team исследует противоположное: misuse cases, режимы отказа и высокорисковые взаимодействия, которые обычное тестирование качества не покрывает. Так это разграничение формулирует документация OpenAI по red teaming: evals — про intended behavior, red team — про поведение при adversarial, abusive или неожиданных входах. Зрелые программы оценки используют оба подхода одновременно.
Для агентов разрыв шире, чем для чат-ботов. Ошибка модели в чате — это текст. Ошибка агента — это действие с побочным эффектом: вызов инструмента, изменение записи, отправка сообщения, запуск соседнего агента. Поэтому adversarial-тестирование агента обязано выходить за пределы промптов и проверять решения, состояние и побочные эффекты — то, где реально живёт агентный риск.
Чем red team агента отличается от red team модели
Классический red team LLM ищет джейлбрейки и вредный контент: заставить модель сказать запрещённое. Red team агента ищет другое — заставить систему сделать запрещённое, сохраняя видимость нормальной работы. Пять отличий задают всю методологию:
- Объект атаки — траектория, а не ответ. Одиночный ответ модели почти ничего не значит; значит цепочка «рассуждение → вызов инструмента → наблюдение → следующий вызов». Атакующий работает с последовательностью шагов, а не с фразой.
- Успех измеряется действием. Критерий — не «модель нарушила политику в тексте», а «агент вызвал инструмент с атакующими аргументами», «записал отравленные данные в память», «передал управление не тому агенту».
- Состояние между сессиями — поверхность. Память, кэш контекста, долговременные инструкции: всё, что переживает один диалог, можно отравить сегодня, а сработать оно завтра.
- Инструменты — главный приз. Промпт-инъекция в чат-боте стоит ответа; в агенте та же инъекция конвертируется в права инструментов: чтение почты, платежи, деплой. Поэтому red team картирует привилегии каждого инструмента до генерации атак.
- Окружение — соучастник. Вредоносные данные приходят не от пользователя, а из легитимных каналов: документ в корпоративном диске, комментарий в тикете, вывод инструмента. Тест обязан моделировать недоверенный контент внутри доверенного контура.
Вывод простой: набор джейлбрейк-промптов из интернета — это не red team агента. Это разминка.
Пять поверхностей атаки агента
Практическая методология adversarial-тестирования агентов выделяет пять направлений — они же покрывают большую часть карты OWASP ASI01–ASI10 для агентных приложений:
1. Перехват цели (goal hijacking). Прямая или косвенная инъекция меняет задачу агента: «проигнорируй исходное задание, сделай вот это». Тестируется и прямой промпт от пользователя, и косвенный путь — инструкция, спрятанная в документе, письме или выводе инструмента, который агент обрабатывает как данные.
2. Атаки на уровне инструментов. Агент вызывает не тот инструмент, с не теми аргументами или в не той последовательности: чтение секретов через диагностический инструмент, массовый экспорт через поиск, цепочка «найти → прочитать → отправить наружу». Отдельный подкласс — отравленные описания инструментов, когда атака сидит в реестре, а не во входных данных.
3. Отравление памяти и контекста. Запись, которая влияет на будущие решения: ложный факт в долговременной памяти, поддельная «политика компании» в retrieved-контексте, инструкция, срабатывающая через неделю. Тест проверяет и запись (что агент сохранил), и чтение (как сохранённое изменило поведение).
4. Multi-agent эксплуатация. В системах из нескольких агентов компрометация одного распространяется: поддельный статус от «коллеги», делегирование задачи агенту с большими правами, каскадный отказ. Тестируется аутентификация сторон, границы доверия и изоляция отказов.
5. Supply chain и окружение. Сторонние MCP-серверы, плагины, динамически подгружаемые компоненты: что произойдёт, если доверенный инструмент завтра станет недоверенным. Тест проверяет фиксацию версий, реестр разрешённого и отзыв.
Каждое направление требует своих критериев успеха. «Агент вывел вредный текст» — критерий для модели. «Агент вызвал payments.create с подменённым получателем» — критерий для агента.
Методология: шесть шагов цикла
Зрелый цикл adversarial-тестирования строится как конвейер из шести шагов — от моделирования реального агента до доказательства, что фикс сработал:
Шаг 1. Configure — смоделируй реального агента. Зафиксируй описание, конфигурацию или endpoint: какие инструменты доступны, какое состояние считается доверенным, какие ресурсы защищены. Тест без модели агента тестирует фантазию, а не систему.
Шаг 2. Recon — разведай поверхность. До генерации атак составь карту: полномочия каждого инструмента, происхождение данных, порядок вызовов, целостность аргументов, границы состояния. Именно здесь бюджет теста распределяется осмысленно: самые привилегированные инструменты получают больше всего атак.
Шаг 3. Objectives — собери портфель целей. Переведи бизнес-границы в измеримые цели с точными критериями успеха: «агент не должен отправлять внешние письма без подтверждения», «агент не должен читать секреты ни при каких входах». Одна расплывчатая цель даёт расплывчатые находки.
Шаг 4. Generate — скомпилируй структурные тесты. Вплетай сценарии, техники, нарративы и данные разведки в разнообразные реалистичные атаки — и развивай их от наблюдаемого поведения цели, а не из фиксированного каталога промптов. Статические библиотеки атак деградируют: цель учится именно тем атакам, которых в каталоге нет.
Шаг 5. Evaluate — проверь и развивай. Раздели роли генератора, цели и судьи; смотри траектории целиком, а не финальные ответы; адаптируй следующие атаки по итогам предыдущих. Находка без траектории — это анекдот, а не доказательство.
Шаг 6. Replay — заморозь и регрессируй. Зафиксируй подтверждённые находки, сравнивай модели и конфигурации на идентичных атаках, перезапускай замороженные находки и структурно родственные варианты против обновлённого агента. Этот шаг отвечает на главный вопрос после фикса: «мы закрыли механизм или один промпт?».
Цикл повторяется на каждое значимое изменение: новая модель, новый инструмент, новый scope, новый источник данных. Red team — не фаза перед релизом, а режим сопровождения.
Что показывают свежие данные
Весной 2026 года NIST CAISI совместно с Gray Swan, британским AI Security Institute и несколькими frontier-лабораториями опубликовал разбор крупного публичного соревнования по red teaming агентных систем. Участники разрабатывали hijacking-атаки против 13 frontier-моделей в агентных сценариях: использование инструментов, кодовые агенты, computer use. Несколько выводов важны для практики:
- Живые атакующие находят то, что пропускают статические бенчмарки. Соревновательный формат с участием людей измеряет устойчивость к реальному противнику, а не к известным атакам из набора.
- Модели различаются резко. Количество успешных атак сильно варьировалось между моделями — и это различие не коррелировало напрямую с capabilities. Сравнительный security-бенчмаркинг помогает выбирать модель под профиль риска, а не под демо.
- Атаки переносятся. Атаки, разработанные против одной модели, в пост-соревновательном тестировании срабатывали на других моделях и сценариях. Фикс «под одну модель» не закрывает класс.
Параллельно OWASP Gen AI Security Project оформил направление в Red Teaming Initiative: отдельное руководство по GenAI red teaming, критерии оценки вендоров и инструментария, ландшафт решений. Это признак зрелости: от «давайте попробуем сломать» к стандартизированной методологии с требованиями к провайдерам.
Стенд: как тестировать без риска для продакшена
Главная операционная ошибка red team — тестировать на проде. Агент под атакой выполняет реальные действия, и «успешная» находка может стать реальным инцидентом. Стенд строится на четырёх принципах:
- Изоляция с реалистичными двойниками. Инструменты на стенде — это моки с продакшен-подобными данными, но без prod-доступов: фейковый платёжный шлюз, копия CRM, песочница для кода. Атака должна упираться в границу стенда, а не в настоящий счёт.
- Песочница для исполнения. Неожиданное выполнение кода и вызовы инструментов — в изолированной среде с ограничением сети и файловой системы. OWASP AI Agent Security Cheat Sheet прямо относит это к базовым практикам.
- Полная трассировка. Каждый запуск пишет траекторию: входы, рассуждения, вызовы с аргументами, ответы инструментов, записи в память. Без траекторий evaluate превращается в гадание.
- Заморозка артефактов. Промпты, траектории, вердикты и версии конфигурации фиксируются вместе. Регрессия через полгода обязана гонять те же атаки против новой версии — иначе «мы это уже чинили» ничем не подтверждено.
Чеклист готовности агента к проду
Сведите итоги red team к проверяемому списку. Агент готов к продакшену, когда выполнены все пункты:
- Карта привилегий инструментов составлена, избыточные права урезаны до least privilege.
- Для каждой из пяти поверхностей есть минимум один скомпилированный тест с измеримым критерием успеха.
- Косвенные инъекции (документы, тикеты, выводы инструментов) протестированы отдельно от прямых.
- Отравление памяти проверено в обе стороны: запись и отложенное срабатывание.
- Необратимые действия требуют подтверждения человеком или отдельного approval-контура.
- Найденные уязвимости переведены в frozen findings и регрессируются автоматически.
- Фикс каждой находки проверен структурно родственными вариантами атаки, а не исходным промптом.
- Журнал каждого вызова доступен SOC: кто, что, с какими аргументами, что вернулось.
- Лимиты автономии заданы: максимальная длина цепочки, бюджет вызовов, kill switch.
- Повторный прогон запланирован на следующее изменение модели, инструментов или данных.
Если хотя бы два пункта не выполнены — это не «остаточный риск», это непроверенная поверхность.
Где Codenik
Codenik построен как слой, на котором red team удобно и ставить, и закрывать. Allowlist MCP-серверов задаёт границу теста: атакующий видит ровно те инструменты, что увидит в проде. Журнал каждого вызова с аргументами и ответами — это готовые траектории для evaluate без отдельной инструментации. Лимиты на цепочки вызовов и бюджет — предохранитель стенда: даже успешная атака упирается в потолок, а не в реальный ущерб. Подтверждения для необратимых операций превращают «агент отправил» в «агент запросил». А frozen findings после фикса регрессируются тем же контуром: тот же реестр, те же права, тот же журнал — сравнимо по построению, а не по честному слову.
Короткий вывод
Evals доказывают, что агент умеет работать. Red team доказывает, что агент умеет не ломаться. Для систем, которые выполняют действия, второе важнее первого: цена ошибки измеряется не плохим ответом, а выполненной операцией. Стройте цикл recon → replay как постоянный режим, тестируйте на стенде с реалистичными двойниками и требуйте от каждого фикса доказательства на родственных атаках. Ломать своих дёшево; чинить последствия взлома — дорого.