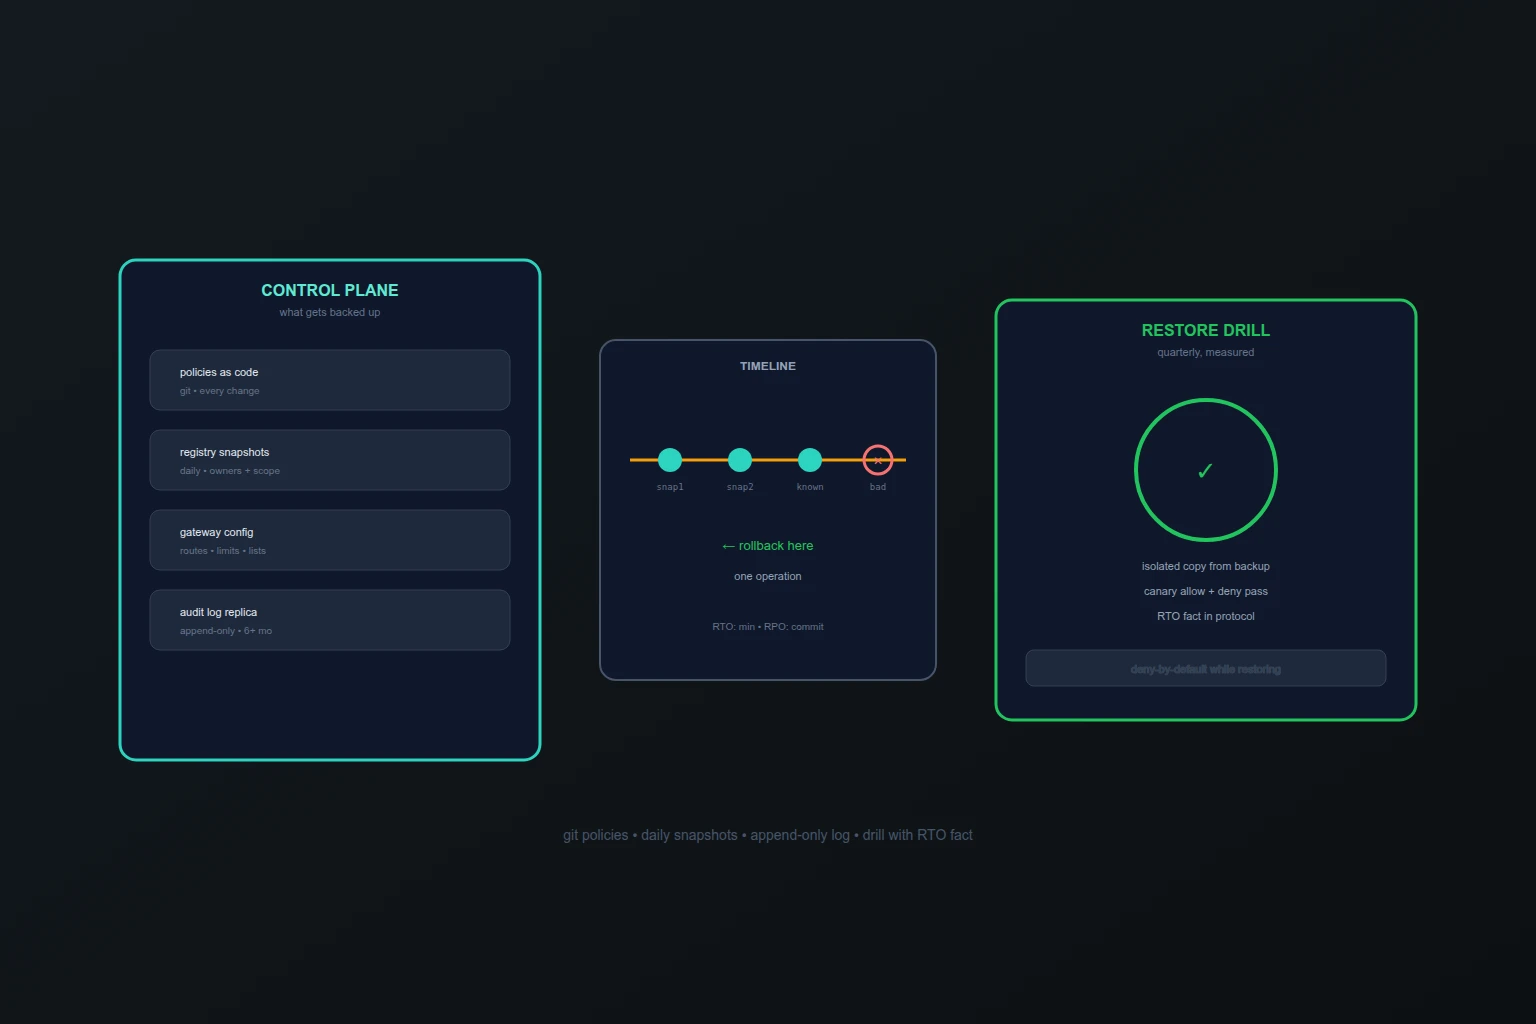
Агенты бегают в проде, а их control plane — политики доступа, реестр серверов, scope и конфиги — живёт в админке шлюза и нигде больше. Одна битая правка политики закрывает доступ половине компании; случайное удаление реестра превращает аудит в тыкву. Обычные серверы бэкапят по привычке, а управляющую плоскость агентов — нет, потому что её «не видно» в CMDB. Зря: восстановить её по памяти невозможно.
Что теряется при потере control plane
Не просто «настройки», а пять вещей сразу: кто и куда имеет доступ (реестр + scope), по каким правилам (политики), кто это утверждал (approve-история), что происходило (журнал вызовов за retention-период) и в каком состоянии что было (версии). Без первого агенты либо стоят, либо — хуже — работают на дефолтных широких правах после «быстрого восстановления». Отраслевые рекомендации по версионированию агентов называют это прямо: нужен процесс возврата к known-good состоянию при регрессии или compliance-проблеме, иначе деградация вместо восстановления.
Состав бэкапа: 5 компонентов
- Политики как код — репозиторий с историей: кто, когда, что поменял, с approve. Git здесь и бэкап, и аудит изменений.
- Реестр агентов и серверов — снапшоты с владельцами, scope,
last_review. Ежедневно, с хранением по retention-политике. - Конфигурация шлюза — маршруты, лимиты, квоты, allowlist. Версионируется вместе с политиками: лимит — тоже контроль.
- Секреты и их метаданные — сами секреты в хранилище с репликацией; в бэкапе шлюза — ссылки и версии, а не значения. Бэкап с секретами в открытом виде — второй инцидент.
- Журнал вызовов — append-only копия за retention-период (6+ месяцев для регулируемых). Нужен не для работы, а для расследований и evidence после восстановления.
RTO/RPO по компонентам
Не один RTO на всё, а по слоям: политики и конфиги — RTO минуты, RPO последний коммит (git тянется быстро); реестр — RTO час, RPO последний дневной снапшот; журнал — RTO часы, RPO ноль потерь (репликация, а не периодический бэкап). Отдельно фиксируется деградированный режим: если шлюз поднялся без свежих политик — deny-by-default, а не «разрешить всё, пока чиним». Открытый доступ во время восстановления хуже простоя.
Restore drill
Бэкап без проверенного восстановления — надежда. Раз в квартал: поднимается изолированная копия control plane из бэкапа, сверяется число политик/агентов/scope с продом, прогоняется канареечный вызов (allow и deny), замеряется время. Результаты — в протокол с RTO-фактом. Практика Day-2 операций подтверждает связку: freeze неизменяемой версии плюс бинарный экспорт для DR — версия защищает от плохих изменений, экспорт от потери инфраструктуры.
Частые провалы
- бэкапят виртуалки со шлюзом, но не смысл — восстановить можно, понять что внутри нельзя;
- политики правятся в UI мимо git — история genuinely отсутствует;
- секреты лежат в том же бэкапе открытым текстом;
- restore ни разу не прогоняли — в день Х выясняется, что снапшоту полгода;
- после восстановления забывают сверить scope — агенты работают шире, чем до сбоя.
Где Codenik
Codenik держит политики и реестр как версионируемый код: каждое изменение — коммит с автором и approve, откат к known-good — одна операция. Снапшоты реестра — ежедневно, журнал — append-only с репликацией. Restore drill сводится к подъёму копии и сверке канареек, а не к археологии по скриншотам админки.
Короткий вывод
Control plane агентов бэкапится как прод: политики в git, реестр в снапшотах, журнал в репликации, восстановление — drill по расписанию с замером RTO. Потерять можно сервер; потерять понимание, кто куда имел доступ, — нельзя.